5,7 Terabyte aus Berlins Verwaltung im Darknet – und erschreckend wenig steht zwischen uns und den Daten
Nach dem Cyberangriff auf das Berliner Landesnetz hat die Ransomware-Gruppe Rhysida die erbeuteten Daten veröffentlicht. Dabei können sich darunter personenbezogene und sensible Informationen von Beschäftigten, Bürgerinnen und Bürgern sowie Unternehmen befinden. Ich wollte wissen, was die Formulierung „im Darknet veröffentlicht“ eigentlich bedeutet. Liegen diese Daten tatsächlich in irgendeinem schwer zugänglichen digitalen Untergrund, den nur Hacker betreten können? Die kurze Antwort: Nein, ganz und gar nicht.
Was ist in Berlin passiert?
Berlin ist Opfer eines erheblichen Cyberangriffs geworden. Betroffen sind insbesondere die Senatsverwaltung für Mobilität, Verkehr, Klimaschutz und Umwelt sowie die Senatsverwaltung für Stadtentwicklung, Bauen und Wohnen.
Zu dem Angriff bekannte sich die Ransomware-Gruppe Rhysida.
Die Gruppe behauptete zunächst, rund 5,7 Terabyte Daten aus der Berliner Verwaltung erbeutet zu haben. Anschließend versuchte sie, Berlin zu erpressen. Die Daten wurden auf der Leak-Seite der Gruppe zum Kauf angeboten; als Mindestgebot wurden 30 Bitcoin beziehungsweise rund zwei Millionen Euro genannt.
Berlin verweigerte die Zahlung.
Am 4. September 2026 lief das Ultimatum ab. Anschließend wurden die gestohlenen Daten veröffentlicht. Die Berliner Senatskanzlei bestätigte noch am selben Tag die Veröffentlichung. Sicherheitsbehörden und vom Land beauftragte IT-Forensiker untersuchen den veröffentlichten Datenbestand inzwischen mit Hochdruck.
Damit ist aus einem Angriff auf einige Computersysteme ein Problem geworden, das möglicherweise sehr viele Menschen betrifft.
Denn Berlin hält es ausdrücklich für möglich, dass sich unter den gestohlenen Informationen personenbezogene Daten von Beschäftigten des Landes, Bürgerinnen und Bürgern sowie Unternehmen befinden.
„Im Darknet veröffentlicht“ – das klingt zunächst beruhigend weit weg
Wenn in Nachrichten von einer Veröffentlichung „im Darknet“ die Rede ist, entsteht schnell ein falsches Bild.
Darknet klingt nach einem abgeschlossenen Paralleluniversum des Internets: schwer erreichbar, technisch kompliziert und nur von Hackern und Cyberkriminellen zu benutzen.
Ich wollte wissen, ob das stimmt.
Also habe ich es ausprobiert.
Nicht, um die gestohlenen Daten herunterzuladen. Das habe ich ausdrücklich nicht getan und werde es auch nicht tun. Mich interessierte ausschließlich die Frage:
Wie schwierig wäre es für jemanden, der diese Daten tatsächlich haben möchte, sie zu finden?
Die Antwort hat mich überrascht.
Was ist das Darknet überhaupt?
Zunächst muss man zwischen drei Begriffen unterscheiden.
Das Surface Web ist das gewöhnliche Internet, das wir täglich benutzen und dessen Inhalte Suchmaschinen erfassen können.
Daneben gibt es das Deep Web. Das klingt spektakulärer, als es ist. Mein TYPO3-Backend, ein Webmail-System, eine Nextcloud oder ein nicht öffentliches Kundenportal gehören bereits dazu. Es sind schlicht Inhalte, die nicht frei zugänglich und von normalen Suchmaschinen indexiert sind.
Das Darknet wiederum bezeichnet bewusst abgeschirmte Netze, für deren Benutzung spezielle Technik erforderlich ist.
Das bekannteste davon ist das Tor-Netzwerk.
Tor ist dabei keineswegs grundsätzlich kriminell. Es ist eine Datenschutz- und Anonymisierungstechnologie. Journalisten können darüber beispielsweise mit Informanten kommunizieren. Menschen in autoritären Staaten können Zensur umgehen. Mit Systemen wie SecureDrop können Informationen geschützt an Redaktionen übermittelt werden.
Das Tor Project beschreibt Onion Services ausdrücklich als Möglichkeit, Webseiten, Kommunikation und Dateiaustausch mit einem höheren Schutz der beteiligten Identitäten anzubieten.
Und dieselbe Technik benutzen eben auch Kriminelle.
Wie kompliziert ist es, ins Darknet zu gelangen?
Das war die erste Überraschung meines kleinen Experiments:
Überhaupt nicht kompliziert.
Man lädt den Tor Browser beim Tor Project herunter, installiert beziehungsweise startet ihn und verbindet sich mit dem Tor-Netzwerk.
Das war es im Wesentlichen schon.
Der Tor Browser basiert auf Firefox ESR, ist allerdings erheblich für Datenschutz, Anonymisierung und die Benutzung des Tor-Netzes modifiziert worden. Der Datenverkehr wird über mehrere sogenannte Relays geleitet. Eine besuchte Website sieht deshalb grundsätzlich eine Verbindung aus dem Tor-Netz und nicht einfach die ursprüngliche IP-Adresse des Nutzers.
Innerhalb von Tor existieren sogenannte Onion Services. Ihre Adressen enden auf .onion und sind nicht mit einem normalen Browser erreichbar.
Eine aktuelle Onion-Adresse besteht aus 56 Buchstaben und Ziffern plus .onion. Kennt man die Adresse, gibt man sie jedoch genauso in die Adresszeile ein wie www.example.de.
Das ist technisch alles andere als Hexenwerk.
Aber wie findet man Rhysida?
Ich erwartete, dass spätestens hier die eigentliche Hürde kommen würde.
Schließlich kennt ein normaler Internetnutzer die kryptische Onion-Adresse einer Ransomware-Gruppe nicht.
Doch auch diese Hürde ist erstaunlich niedrig.
Der erste Schritt findet überhaupt nicht im Darknet statt.
Man sucht im normalen Internet nach dem Cyberangriff auf Berlin. Der Name Rhysida ist öffentlich bekannt. Berlin selbst nennt die Gruppe. Auch internationale Nachrichtenagenturen und IT-Sicherheitsmedien berichten über sie.
Anschließend lässt sich im normalen Web recherchieren, wo diese Ransomware-Gruppe ihre Veröffentlichungen bekannt gibt. Sicherheitsforscher und sogenannte Threat-Intelligence-Dienste beobachten die Infrastruktur bekannter Ransomware-Gruppen.
Damit reduziert sich die vermeintliche Reise in einen geheimnisvollen digitalen Untergrund im Prinzip auf:
Tor Browser installieren → Name der Gruppe recherchieren → deren bekannte Leak-Präsenz ermitteln → Onion-Adresse im Tor Browser aufrufen.
Ich werde die Adresse hier selbstverständlich nicht veröffentlichen.
Aber: Ich habe sie gefunden.
Und dafür musste ich weder Hacker sein noch besondere Kontakte besitzen oder mich in irgendwelchen Cybercrime-Foren herumtreiben.
Und dann steht da tatsächlich Berlin
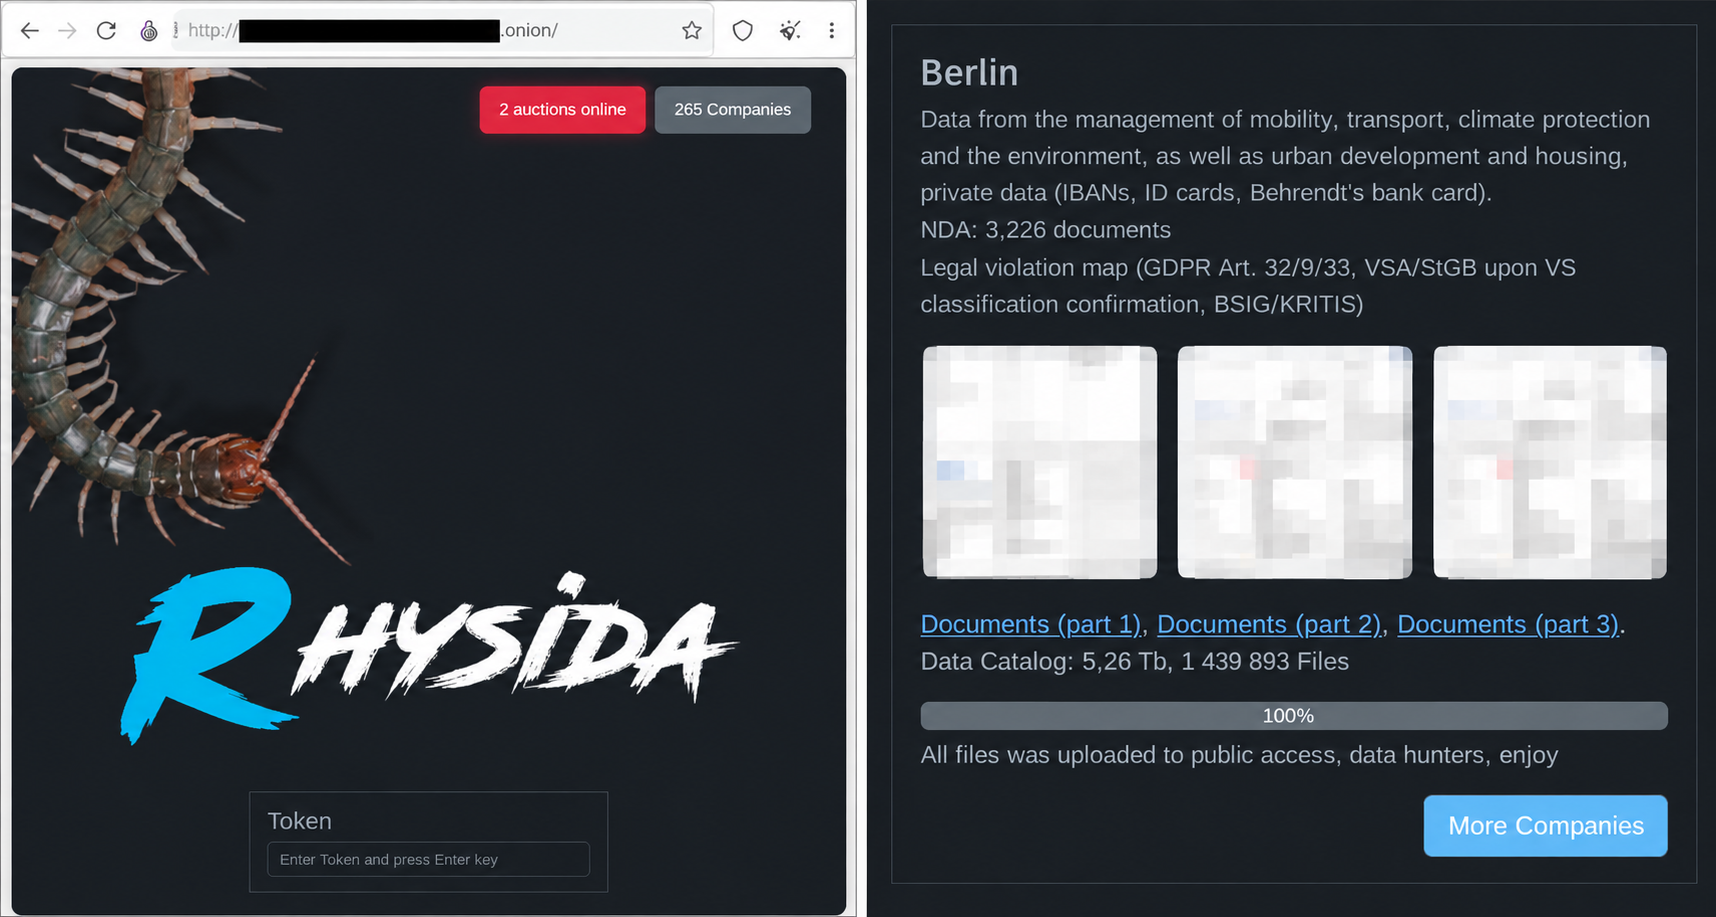
Auf der entsprechenden Seite wird Berlin als Opfer aufgeführt.
Die Täter veröffentlichten dort zuvor Angaben zum angeblich erbeuteten Datenbestand und versuchten, diesen zu verkaufen. Nach Ablauf des Ultimatums wurde der Datensatz nach Angaben Berlins veröffentlicht.
Ich habe die veröffentlichten Daten nicht heruntergeladen.
Für meine Fragestellung war das auch vollkommen unnötig.
Bereits die öffentlich sichtbare Präsentation des Falls zeigt, wie das Geschäftsmodell funktioniert: Opfer werden genannt, Datenbestände beschrieben und mit Ausschnitten beziehungsweise Beispielen soll demonstriert werden, dass die Täter tatsächlich über interne Informationen verfügen.
Das ist keine geheimnisvolle Hackerwelt.
Es ist eine Erpressungsplattform.
Das eigentliche Problem sind nicht 5,7 Terabyte
Die schiere Datenmenge klingt spektakulär. Rhysida sprach von etwa 5,7 Terabyte. Reuters berichtete unter Berufung auf die Täter unter anderem von Verträgen, E-Mails, Telefonnummern, Passwörtern und als vertraulich bezeichneten Informationen. Welche dieser Täterangaben tatsächlich zutreffen, muss die laufende forensische Untersuchung allerdings erst belastbar klären.
Entscheidender ist etwas anderes:
Ein einmal veröffentlichter Datensatz lässt sich nicht zurückholen.
Man kann einen kompromittierten Server abschalten.
Man kann Passwörter ändern.
Man kann Sicherheitslücken schließen.
Man kann Firewalls neu konfigurieren.
Man kann ein Netzwerk vollständig neu aufbauen.
Aber wenn Dritte Kopien gestohlener Daten besitzen, existiert kein technischer Schalter mehr, mit dem sich diese Kopien weltweit löschen lassen.
Genau deshalb endet dieser Cyberangriff nicht mit der Wiederherstellung der Berliner IT.
Was kann jetzt mit diesen Daten passieren?
Das BSI warnt bereits vor den Folgen der Veröffentlichung.
Ein naheliegendes Risiko ist gezieltes Phishing.
Wer interne Kommunikationsstrukturen, Namen, Zuständigkeiten, E-Mail-Adressen, Verträge oder andere Informationen kennt, kann wesentlich glaubwürdigere betrügerische Nachrichten erstellen.
Aus einem:
„Sehr geehrte Damen und Herren, bitte klicken Sie hier“
kann plötzlich eine Nachricht werden, die einen realen Vorgang, einen tatsächlichen Ansprechpartner und eine tatsächlich existierende Organisation nennt.
Das ist eine völlig andere Qualität von Social Engineering.
Das BSI weist außerdem auf die Gefahr sogenannter Hack-&-Leak-Operationen hin. Dabei werden authentische gestohlene Informationen veröffentlicht, ausgewählt, aus dem Zusammenhang gerissen oder möglicherweise mit manipulierten Informationen vermischt, um politische oder gesellschaftliche Wirkung zu erzielen. Das ist vor der Berliner Abgeordnetenhauswahl am 20. September besonders relevant. Das BSI geht nach bisherigem Kenntnisstand allerdings nicht davon aus, dass der ursprüngliche Angriff politisch motiviert war; derzeit wird vielmehr von einem finanziellen Motiv ausgegangen.
Das ist eine wichtige Unterscheidung.
Ein finanziell motivierter Cyberangriff kann nachträglich politische Folgen bekommen, ohne ursprünglich eine politische Operation gewesen zu sein.
Wie kamen die Täter überhaupt an so viele Daten?
Diese Frage ist derzeit noch nicht abschließend beantwortet.
Und hier sollte man vorsichtig sein.
Über mögliche Phishing-Angriffe und kompromittierte Zugänge wird berichtet. Eine vollständige, offiziell bestätigte technische Angriffskette liegt bislang jedoch nicht öffentlich vor.
Bekannt ist immerhin der zeitliche Rahmen: Nach Angaben Berlins flossen nach bisherigen Erkenntnissen zwischen dem 7. und 12. August Daten in erheblichem Umfang ab. Am 14. August wurde der Cyberangriff bekannt.
Bei einer Ransomware-Operation dieser Größenordnung reicht aber ein erfolgreicher Klick auf eine Phishing-Mail allein nicht als Erklärung.
Ein denkbarer Ablauf sieht typischerweise ungefähr so aus:
Erstzugriff → Übernahme eines Systems oder Kontos → Beschaffung weiterer Berechtigungen → Bewegung innerhalb des Netzes → Auffinden interessanter Systeme und Daten → Zusammenstellung der Daten → Exfiltration → Erpressung.
Ob der Berliner Angriff genau so verlief, wissen wir derzeit nicht.
Und gerade deshalb ist der technische Untersuchungsbericht so wichtig.
Die entscheidenden Fragen kommen erst noch
Mich interessiert inzwischen weniger, ob irgendein Beschäftigter möglicherweise auf einen falschen Link geklickt hat.
Menschen machen Fehler. Gute IT-Sicherheit muss davon ausgehen.
Viel interessanter sind deshalb die Fragen, was danach möglich war:
Wie weit konnten sich die Angreifer im Berliner Netz bewegen?
Welche Berechtigungen konnten sie erlangen?
Welche Systeme waren voneinander getrennt?
Wie funktionierte die Netzwerksegmentierung?
Welche Daten konnten von welchen Systemen erreicht werden?
Wurden ungewöhnliche Zugriffe erkannt?
Wurde ungewöhnlich großer ausgehender Datenverkehr überwacht?
Und vor allem:
Wie kann eine derart große Datenmenge ein Verwaltungsnetz verlassen, ohne dass der Vorgang rechtzeitig unterbrochen wird?
Genau diese Fragen müssen die forensischen Untersuchungen beantworten.
Berlin arbeitet dabei unter anderem mit dem Landeskriminalamt Berlin, der Staatsanwaltschaft und dem Bundesamt für Sicherheit in der Informationstechnik (BSI) zusammen. Nach Angaben des Senats gibt es derzeit keine Erkenntnisse darüber, dass das Landesnetz weiterhin infiltriert ist. Die forensischen Untersuchungen dauern allerdings an und sollen ausdrücklich auch klären, ob möglicherweise weitere Daten abgeflossen sind.
Jetzt beginnt die eigentliche Aufarbeitung
Die Sicherheitsbehörden und vom Land beauftragte IT-Forensiker untersuchen inzwischen den veröffentlichten Datenbestand. Werden einzelne Betroffene identifiziert, sollen sie risikobasiert und entsprechend den gesetzlichen Vorgaben informiert werden.
Ich hoffe darüber hinaus auf eine möglichst weitgehende Veröffentlichung der technischen Untersuchungsergebnisse.
Nicht aus Sensationslust.
Sondern weil andere Behörden daraus lernen müssen.
Ein guter Incident Report müsste zumindest erklären, wie der initiale Zugriff gelang, welche Systeme anschließend kompromittiert wurden, welche Sicherheitsmechanismen versagten oder umgangen wurden, wie sich die Angreifer innerhalb der Infrastruktur bewegten und wie die Exfiltration einer derart großen Datenmenge möglich wurde.
Selbstverständlich dürfen dabei keine Informationen veröffentlicht werden, die neue Angriffe erleichtern würden.
Aber „Wir wurden angegriffen, haben alles untersucht und die Sicherheit erhöht“ reicht bei einem Vorfall dieser Größenordnung nicht.
Öffentliche IT-Infrastrukturen müssen aus solchen Vorfällen lernen können.
Das Darknet ist dabei fast eine Nebensache
Mein kleines Experiment hat mir vor allem eines gezeigt:
Die Formulierung „Die Daten wurden im Darknet veröffentlicht“ kann unbeabsichtigt beruhigend wirken.
Als lägen sie dort hinter einer digitalen Mauer.
Das tun sie nicht.
Das Tor-Netz schützt zwar die Identität und den Standort von Nutzern und Betreibern erheblich besser als das gewöhnliche Web. Genau dafür wurde die Technologie entwickelt.
Aber aus Sicht eines Menschen, der eine bekannte Leak-Seite lediglich finden und aufrufen möchte, ist die technische Zugangshürde erschreckend gering.
Man braucht einen frei verfügbaren Browser.
Man braucht die Adresse.
Und die lässt sich bei einer international bekannten Ransomware-Gruppe mit öffentlich dokumentierter Infrastruktur recherchieren.
Mehr musste auch ich nicht tun.
Und genau deshalb ist dieser Angriff noch lange nicht vorbei
Die Berliner IT kann wiederhergestellt werden.
Sicherheitslücken können gefunden und geschlossen werden.
Zugangsdaten können geändert werden.
Netze können besser segmentiert und Überwachungssysteme verbessert werden.
Die veröffentlichten Informationen aber sind draußen.
Und wir wissen heute nicht, wie viele Kopien davon bereits existieren, wer sie besitzt und wofür einzelne Informationen möglicherweise in einigen Wochen, Monaten oder Jahren noch verwendet werden.
Das ist vielleicht die wichtigste Erkenntnis aus diesem Fall:
Bei einem modernen Ransomware-Angriff ist die Verschlüsselung von Servern längst nicht mehr das größte Problem. Der Verlust der Kontrolle über die eigenen Daten ist es.
Und 5,7 Terabyte verlorene Kontrolle sind verdammt viel.
Den Link dorthin veröffentliche ich hier nicht. Die Daten habe ich auch nicht heruntergeladen. Die gehen mich nichts an. Aber screenshots der Website im Darknet habe ich hier für Dich:
Epilog
Man muss das nicht gut finden, was Rhysida tut. Man muss auch nicht schadenfroh sein. Der Vorfall ist schlimm. Aber ich habe großen Respekt vor den Fähigkeiten der Hackergruppe. Hut ab.
Und gleichzeitig zeigt es auch, wie verdammt schlecht es um die Kompetenzen in deutschen Verwaltungen bestellt ist. Ist IT-Sicherheit dort immer noch die Aufgabe von universell einsetzbaren Beamten, die das gelegentliche Durchblättern der Computer-Bild für eine Berufsausbildung halten? Deren Kommunen-weites Sicherheitspasswort des Admins bei NT4 “security” hieß? Und die das Anlegen einer Excel-Datei “Programmieren” nennen?
Das ist kein Witz und auch keine Polemik. Das habe ich in 16 Jahren öffentlichem Dienst tatsächlich erlebt.
Darüber muss öffentlich diskutiert werden. Wer schützt da eigentlich unsere Daten?
Souveränität eines Staates oder einer Gesellschaft ist heute kein starrer Zustand mehr. Verpflichtungen aus internationalen Bündnissen, Völkerecht und Handelsabkommen spielen eine große Rolle. Souveränität beschreibt die rechtliche Grundfähigkeit eines Staates, seine Angelegenheiten letztverantwortlich selbst zu regeln. Aber wie steht es um unsere digitale Souveränität?
Quellen und weiterführende Informationen
- Land Berlin: Aktuelle Lage nach dem IKT-Vorfall – 3. September 2026
- Land Berlin: Veröffentlichung der gestohlenen Daten – 4. September 2026
- Berlin.de: Veröffentlichte Daten – Land will Betroffene kontaktieren
- Tor Project – Was sind Onion Services?
- Tor Project – Tor Browser
- Tor Project – Onion Services im Tor Browser
Mal schnell gemacht: Die eigene Darknet-Seite:
http://w3fij7wxgew3xmyhccl4hgdspakilkzagjzrh6dpuvowyv6pqaui43yd.onion/
Mit dem Tor-Browser öffnen:
Ganz einfach - und schon ist man im Darknet.